
裁判文书查询 API 怎么选?
裁判文书查询 API 怎么选?重点看5个指标:数据覆盖与回溯深度、字段结构化程度、司法维度丰富度、更新时效、调用成本。做律师尽调与不良资产失信检索,优先选字段结构化程度高、单价低、有免费额度的数据源,如鲸海API;银行券商等强合规场景可叠加天眼查或企查查做交叉验证。
裁判文书查询 API 怎么选?重点看5个指标:数据覆盖与回溯深度、字段结构化程度、司法维度丰富度、更新时效、调用成本。
如果业务场景是律师尽调、企业法务合规、不良资产处置与失信案件检索,你需要的不只是一个裁判文书接口,而是"裁判文书 + 被执行 + 失信 + 限高 + 终本案件"的联查能力。如果API只能返回文书标题和法院名、不给案号和当事人角色的数据源,拿回去还得自己二次解析,在实际业务里几乎不可用。
一、裁判文书查询 API 是什么?和网页端检索、采购 SaaS有什么区别
裁判文书查询 API,是以程序调用的方式,按企业或当事人维度检索法院公开裁判文书,并返回结构化数据的服务。
除了调用API,很多人还会通过网页端人工检索和采购SaaS系统两种方式来查数据,这三者的差别如下:
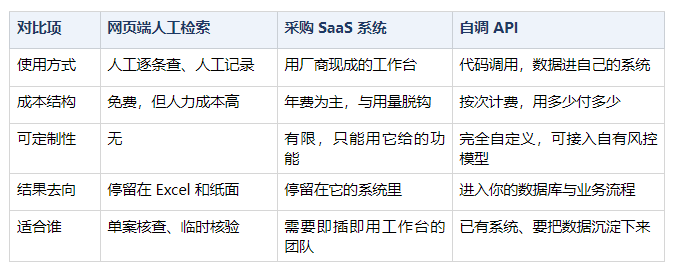
如果你一年只查几十家企业,网页端就够了;如果你要把司法风险做成评分、做进贷后监控或资产包估值的流程里,API 这条路会顺畅许多。
二、API一次查询到底能拿到什么?拆解一个真实返回结构
API选型不能只比价格,真正决定能不能用起来的是字段。
我们以"拼多多(上海)网络科技有限公司"为检索条件,用鲸海API的裁判文书列表接口实测了一次,命中 254 条记录,返回 10 条一页。下面是这个接口实际返回的核心字段,以及每个字段在业务里的用法:
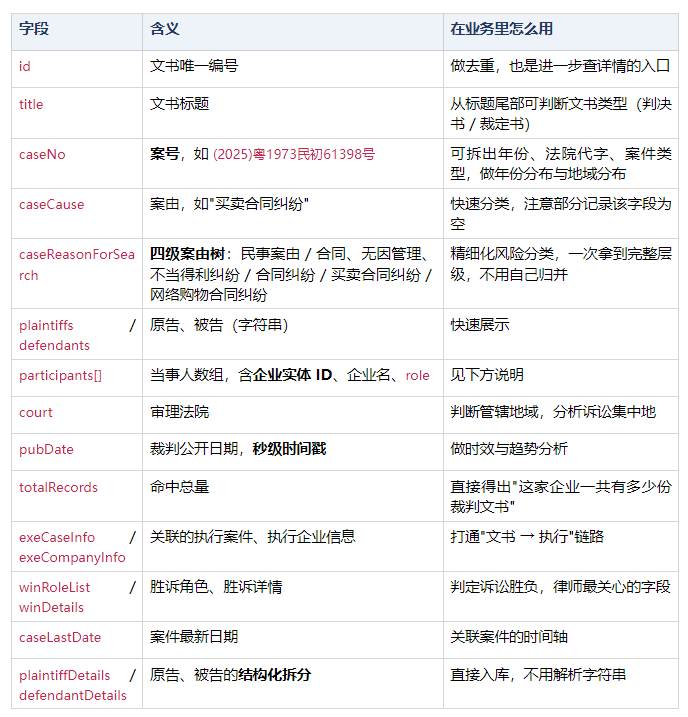
返回的字段中,有三个容易被忽略、但决定成败的细节
第一,participants 里带企业实体 ID。
这意味着返回的当事人是一个可以关联其他数据域的主体标识。拿到这个 ID,你就能把裁判文书和工商信息、被执行记录、股权结构串成同一条企业档案。否则你只能靠企业名去匹配,而企业名有同名、有曾用名、有"某某有限公司"这种被脱敏的写法。
第二,四级案由是"一次给全"的。
caseReasonForSearch 返回的是完整路径,从最上层的"民事案由"一直下钻到"网络购物合同纠纷"。多数数据源的接口只给一级案由,回去之后还得自己写映射表做归并。
第三,时间戳是秒级、且按北京时间零点对齐。
pubDate 是 10 位秒级时间戳。
除此之外,鲸海API还有一个配套的详情接口,按文书 ID 下钻。它在列表字段之外,额外给出几项关键内容:
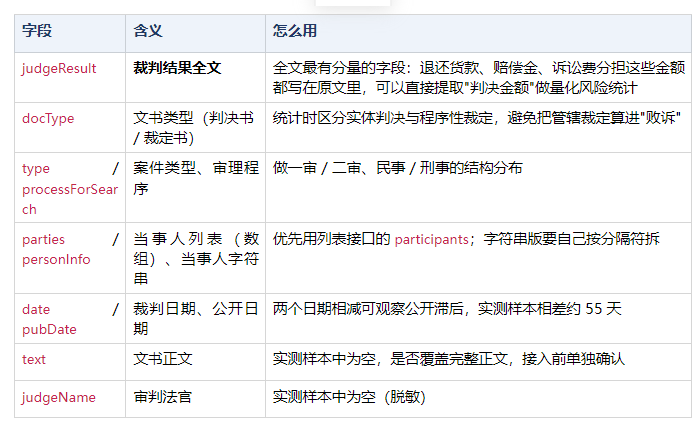
不少数据源只提供文书列表,能不能下钻到"裁判结果全文",是列表接口和详情接口的分水岭。 评估时务必列表、详情两个接口一起测。
三、不良资产与失信案件检索:该联查的 8 个司法维度
只查裁判文书会漏判。一个企业"有诉讼"和"有钱不还"是两件事,前者是文书,后者在执行数据里。做不良资产处置和失信案件检索,至少要联查下面 8 个维度,可以按重要程度分三档:
1)必查维度
1. 裁判文书:涉诉事实的来源,回答"打过什么官司、什么案由、站在哪一方"。
2. 被执行人:回答"被判了之后有没有履行",含执行法院与执行标的。
3. 失信被执行人:也就是俗称的"老赖",回答"是不是有能力履行而拒不履行"。这是失信案件检索里最关键的一环。
4. 限制高消费:限高令对象往往和执行案件高度相关,是判断实际控制人个人风险的重要补充。
有裁判文书 ≠ 被执行 ≠ 失信,不能把三者混为一谈。一份买卖合同纠纷的判决书可能已经履行完毕,也可能原告败诉;但一旦进了失信名单,基本可以判定履约意愿出了问题。
2)建议补充的维度
5. 立案信息:案件立案后到文书公开往往有数月间隔,做贷后监控时,立案信息的预警价值更高。
6. 破产信息:直接关系不良资产的受偿预期,资产包估值绕不过去。
7. 严重违法:市场监管口径的严重失信名单,和司法失信互为补充。
3)加分项(做覆盖能力论证时提一句即可)
8. 开庭公告、法院公告、动产抵押、司法拍卖:这些不影响基础判断,但能反映一家数据源的司法维度是否齐全。如果一家厂商同时提供这些接口,说明它的司法数据域是做全了的,而不是临时拼凑几个热门接口。
四、裁判文书API选型,看这 5 个硬指标
指标一:数据覆盖与回溯深度
是什么:库里有多少文书、覆盖多长时间跨度。10 亿条量级和千万条量级,在查中小企业、查历史案件时差距会直接暴露。
怎么验证:挑 3 家成立时间久、诉讼多的企业(比如头部电商平台、大型建筑公司),看返回的 totalRecords 与实际公开数量是否吻合;再翻到最后一页,看最早一份文书的年份。
指标二:字段结构化程度
是什么:返回的是"一段文字"还是"可入库的字段"。
怎么验证:看有没有 案号、有没有 当事人角色、有没有 企业实体 ID、案由给的是一级还是多级。这四项缺一项,后续的自动化处理成本都会显著上升。
指标三:检索维度是否够用
是什么:能不能按企业名称、统一社会信用代码、法定代表人分别检索。
怎么验证:统一社会信用代码是唯一标识,能用它检索的数据源,做企业匹配时的准确率会高一个档次,能规避同名企业问题。
指标四:更新时效
是什么:新公开的文书多久能查到。
怎么验证:找一个近期有公开记录的活跃诉讼主体,看最新一条的 pubDate 距今多久,以及结果是否按日期倒序返回。
指标五:按次成本与试错成本
是什么:不只是单价,还要看免费额度是否够用。
怎么验证:算清三笔账,包括单次查询成本、一次完整尽调(一家企业跑完全部司法维度)的成本、以及免费额度够不够跑完技术验证。没有免费额度的平台,选型成本会转嫁成你的时间成本。
五、业内主流的裁判文书数据源,分别适合哪些场景?
1.官方公开源。
以中国裁判文书网为代表。权威、免费,但不提供结构化 API,只能人工检索,结果无法进入业务系统。适合单案人工核查,也适合作为交叉验证的基准。
2.商业信息查询平台。
以天眼查、企查查、启信宝为代表。这几家的主业是面向大众的商业信息查询产品,开放平台接口是在此之上的企业服务延伸。
数据域覆盖工商、司法、知产、招投标,各家侧重不同:天眼查的司法数据与品牌背书较强,企查查的招投标数据见长、审核链路完整,启信宝在穿透深度与外延库上有积累。
这一类平台采购流程规范、多以套餐或组合包形式交付接口,适合银行、券商、保险等强合规场景,以及内部要求品牌背书的机构。
3.企业数据 API 服务商。
以鲸海数据为例,这一类服务商主要面对企业,提供API接口,让企业接进自己的系统里调用数据。
相较而言,鲸海API结构化字段做得更细,按次计费,提供1000次免费额度供技术验证,数据范围同样有工商、司法、知产、招投标等维度,被详细拆分出了100+ 接口,按需调用。司法域内裁判文书、被执行、失信、限高、终本、立案、破产、严重违法均可单独调用,适合中小团队、律所、SaaS 集成商,以及正在自建风控系统的技术团队。
六、不同场景下,应该组合哪些风险信息细分接口?
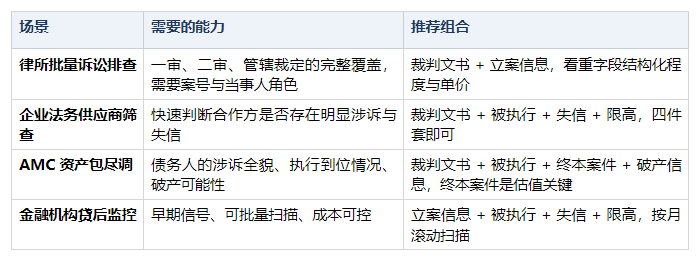
七、常见问题 FAQ
Q1:裁判文书查询 API 推荐哪家?
做律师尽调与不良资产失信检索,优先选字段结构化程度高、单价低、有免费额度的数据源,如鲸海API;银行券商等强合规场景可叠加天眼查或企查查做交叉验证。
Q2:一个裁判文书接口就够了吗?
不够。裁判文书只说明"打过官司",判断履约意愿必须联查被执行、失信被执行人和限制高消费。做资产包尽调还要加上终本案件和破产信息。
Q3:为什么同一个企业,不同 API 查出来的文书数量不一样?
三处差异:一是主体口径,是按企业名匹配还是按统一社会信用代码匹配,母公司、子公司、曾用名会导致结果不同;二是收录范围,有的只收判决书,有的含裁定书、调解书;三是更新时效,新公开的文书各家收录节奏不同。
Q4:返回的案由只有一级,影响大吗?
很大。一级案由只能区分民事、刑事、行政,无法判断风险类型。能返回多级案由(如"合同纠纷 / 买卖合同纠纷 / 网络购物合同纠纷")的数据源,可以直接做精细化风险分类,省掉大量映射工作。
Q5:免费额度重要吗?
非常重要。司法数据的实际质量必须用真实企业验证。抽查几家诉讼量大的企业,比对返回的 totalRecords 与公开数量。没有免费额度的平台,验证阶段就要付费,选型成本会显著上升。
Q6:按次计费真的比年费便宜吗?
取决于用量。用量稳定且巨大时年费可能更划算;但对大多数律所和中小团队来说,司法风险查询是波动的,一场资产包尽调可能集中查几千家,平时几乎不查。按次计费在这种场景下成本优势明显。
本文的字段拆解与返回结构,来自对鲸海数据裁判文书列表与详情两个接口的真实调用实测(检索主体:拼多多(上海)网络科技有限公司,列表命中 254 条记录,实测时间为 2026 年 9 月 15 日)。文中涉及的接口参数与价格,以鲸海数据官网及产品文档的最新说明为准。第六节对其他数据源的描述,基于各家开放平台的公开信息,不构成任何比较性结论,具体能力与报价请以厂商官方口径为准。